وبلاگ
تبدیل کارت گرافیک به سرور هوش مصنوعی محلی با llama.cpp

اگر کارت گرافیک کامپیوتر گیمینگ شما بیشتر ساعات روز بدون استفاده میماند، میتوانید از قدرت پردازشی آن برای اجرای یک سرور هوش مصنوعی محلی استفاده کنید. با این روش، بهجای اجرای مدلهای هوش مصنوعی روی تکتک دستگاهها، یک کامپیوتر قدرتمند را به سرور تبدیل میکنید تا گوشی، لپتاپ و سایر دستگاههای متصل به شبکه خانگی بتوانند از همان مدل استفاده کنند.
این روش علاوه بر کاهش وابستگی به سرویسهای ابری، امکان اجرای مدلهای بزرگتر روی دستگاههایی را فراهم میکند که سختافزار مناسبی برای اجرای مستقیم هوش مصنوعی ندارند. برای راهاندازی چنین سیستمی میتوان از ابزار متنباز llama.cpp استفاده کرد که قابلیت اجرای مدل و ارائه آن از طریق شبکه محلی را در اختیار کاربر قرار میدهد.
چگونه کامپیوتر گیمینگ را به سرور هوش مصنوعی تبدیل کنیم؟
بسیاری از کامپیوترهای گیمینگ به کارتهای گرافیک قدرتمندی مجهز هستند که فقط هنگام اجرای بازی یا نرمافزارهای سنگین از تمام ظرفیت آنها استفاده میشود. در ساعات دیگر، بخش زیادی از توان پردازشی این قطعات بدون استفاده باقی میماند. تبدیل چنین سیستمی به سرور هوش مصنوعی راهی برای استفاده بهتر از سختافزار موجود است.
در این روش، کامپیوتر اصلی وظیفه اجرای مدل هوش مصنوعی را برعهده دارد و سایر دستگاهها فقط از طریق مرورگر به رابط چت آن متصل میشوند. بنابراین لازم نیست روی گوشی یا لپتاپ مدل چندین گیگابایتی دانلود کنید یا سختافزار قدرتمندی داشته باشید.
یکی از ابزارهای مناسب برای این کار llama.cpp است. این پروژه متنباز امکان اجرای مدلهای زبانی با فرمت GGUF را فراهم میکند و با استفاده از قابلیت سرور داخلی خود میتواند پاسخهای تولیدشده را از طریق شبکه در اختیار دستگاههای دیگر قرار دهد.
راهاندازی سرور هوش مصنوعی با llama.cpp در ویندوز
برای شروع به نسخهای از llama.cpp که از شتابدهی کارت گرافیک شما پشتیبانی کند و یک مدل هوش مصنوعی با فرمت GGUF نیاز دارید. اگر از کارت گرافیک انویدیا استفاده میکنید، بهتر است نسخه سازگار با CUDA را تهیه کنید تا پردازش مدل تا حد امکان روی GPU انجام شود.
پس از آماده کردن فایل مدل و برنامه، PowerShell را در ویندوز باز کنید و دستور زیر را اجرا کنید:
llama-server -m "C:pathtoyour-model.gguf" --host 0.0.0.0 --port 8080در این دستور باید مسیر نمونه را با آدرس واقعی فایل مدل خود جایگزین کنید.
پارامترهای مهم این دستور عبارتاند از:
-
-m: مسیر فایل مدل هوش مصنوعی را مشخص میکند. -
--host 0.0.0.0: باعث میشود سرور روی رابطهای شبکه سیستم در دسترس باشد و فقط به کامپیوتر میزبان محدود نشود. -
--port 8080: شماره پورتی را تعیین میکند که دستگاههای دیگر از طریق آن به سرور متصل میشوند.
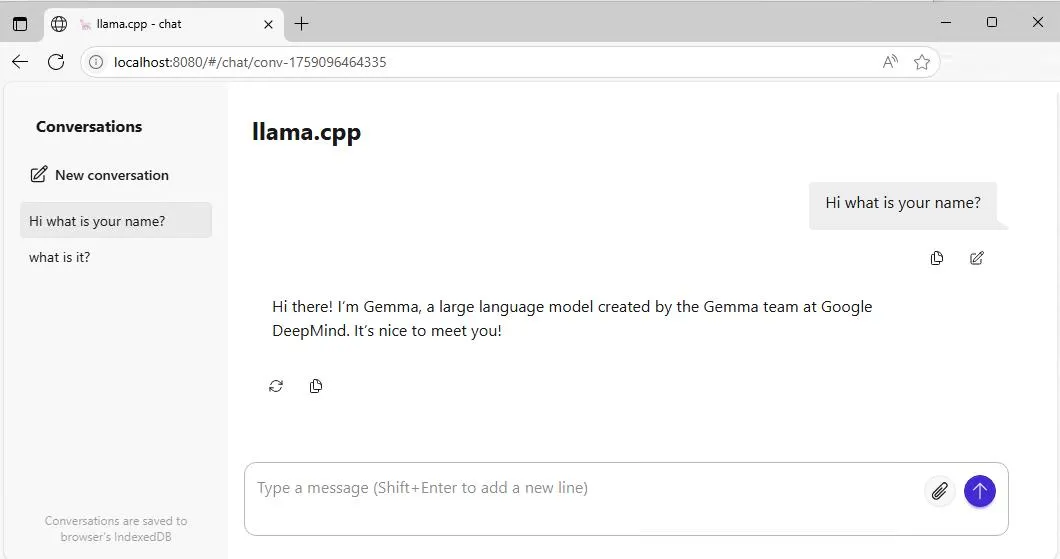
پس از اجرای موفق دستور، سرور آماده دریافت درخواست خواهد بود. رابط وب داخلی llama.cpp نیز امکان گفتگو با مدل را از طریق مرورگر فراهم میکند.
اجرای مدلهای بزرگتر از ظرفیت حافظه کارت گرافیک
یکی از قابلیتهای مهم llama.cpp امکان تقسیم بار پردازشی بین حافظه کارت گرافیک و رم سیستم است. به این ترتیب، حتی اگر حجم مدل از ظرفیت VRAM بیشتر باشد، در برخی شرایط میتوان آن را اجرا کرد.
به عنوان مثال، در یک سیستم مجهز به کارت گرافیک RTX 4070 Ti Super با ۱۶ گیگابایت حافظه و ۳۲ گیگابایت رم، یک مدل Qwen3.6-35B-A3B با حجم تقریبی ۱۷٫۷ گیگابایت اجرا شده است. برای انجام این کار بخشی از وزنهای مدل به حافظه رم منتقل شدهاند.
در تنظیمات پیشرفته llama.cpp میتوان با پارامترهایی مانند -ngl و --n-cpu-moe مشخص کرد چه مقدار از پردازش روی GPU و چه مقدار روی CPU انجام شود. البته میزان بهینه این تنظیمات به معماری مدل و سختافزار سیستم بستگی دارد.
اتصال گوشی و لپتاپ به سرور هوش مصنوعی از طریق شبکه خانگی
بعد از راهاندازی سرور، نوبت به اتصال دستگاههای دیگر میرسد. مزیت اصلی این روش آن است که گوشی، تبلت یا لپتاپ برای استفاده از مدل نیازی به پردازنده گرافیکی قدرتمند یا حافظه زیاد ندارد؛ زیرا تمام محاسبات روی کامپیوتر میزبان انجام میشوند.
کافی است دستگاهها به همان شبکه وایفای یا شبکه کابلی کامپیوتر متصل باشند. سپس با وارد کردن آدرس IP محلی کامپیوتر به همراه شماره پورت انتخابشده، میتوان رابط وب سرور را در مرورگر باز کرد.
به عنوان مثال، اگر آدرس محلی کامپیوتر 192.168.1.100 باشد و سرور روی پورت 8080 اجرا شود، آدرس زیر را در مرورگر دستگاه دیگر وارد کنید:
http://192.168.1.100:8080البته باید آدرس IP واقعی کامپیوتر خود را جایگزین کنید. همچنین ممکن است فایروال ویندوز هنگام اولین اجرا اجازه دسترسی شبکه را درخواست کند. در این شرایط فقط دسترسی موردنیاز برای شبکه خصوصی خانگی را مجاز کنید.
استفاده همزمان چند نفر از یک سرور هوش مصنوعی
یکی دیگر از قابلیتهای جالب llama.cpp امکان مدیریت چند درخواست همزمان است. این ویژگی باعث میشود اعضای خانواده بتوانند بدون نیاز به نصب جداگانه مدل روی دستگاههای خود، از یک سرور مشترک استفاده کنند.
در تنظیمات سرور میتوان تعداد جایگاههای پردازش همزمان را با پارامتر -np تعیین کرد. به عنوان مثال، استفاده از -np 2 دو جایگاه گفتگو ایجاد میکند تا دو کاربر بتوانند همزمان با مدل ارتباط برقرار کنند.
البته افزایش تعداد کاربران به معنی افزایش نامحدود سرعت نیست. با تقسیم منابع پردازشی بین درخواستها، ممکن است سرعت پاسخگویی به هر کاربر کاهش پیدا کند. ظرفیت واقعی نیز به حافظه کارت گرافیک، اندازه مدل و طول مکالمات بستگی دارد.
مصرف برق و عملکرد کارت گرافیک هنگام اجرای سرور هوش مصنوعی
یکی از نکات جالب این روش، مصرف انرژی نسبتاً پایین کارت گرافیک در زمان انتظار است. در آزمایش انجامشده با RTX 4070 Ti Super، مصرف توان گزارششده برای GPU در حالت آمادهبهکار و در حالی که مدل بارگذاری شده بود، حدود ۱۴ وات بود. هنگام تولید پاسخ این مقدار به حدود ۱۳۰ تا ۱۴۰ وات افزایش پیدا میکرد.
این اعداد مربوط به مصرف خود کارت گرافیک هستند و نباید آنها را با مصرف کل کامپیوتر اشتباه گرفت. پردازنده، مادربورد، فنها و سایر قطعات نیز برق مصرف میکنند.
محدودیت حافظه VRAM و تأثیر آن بر اجرای بازیها
مهمترین محدودیت استفاده از کارت گرافیک گیمینگ به عنوان سرور هوش مصنوعی، اشغال شدن حافظه VRAM است. زمانی که مدل روی کارت گرافیک بارگذاری میشود، بخش زیادی از حافظه در اختیار آن قرار میگیرد و فضای کمتری برای بازیها یا نرمافزارهای گرافیکی باقی میماند.
در آزمایش یادشده، مدل حدود ۱۵٫۴ گیگابایت از حافظه ۱۶ گیگابایتی کارت گرافیک را اشغال کرده بود. بنابراین تنها حدود ۶۰۰ مگابایت حافظه آزاد باقی میماند که برای اجرای بسیاری از بازیهای سنگین کافی نیست.
برای حل این مشکل میتوان از مدلهای سبکتر استفاده کرد یا بخشی از پردازش را به رم سیستم منتقل کرد. همچنین اگر کامپیوتر در ساعات مشخصی برای بازی استفاده میشود، بهتر است سرور را پیش از اجرای بازی متوقف کنید.
نکات امنیتی مهم هنگام اشتراکگذاری سرور در شبکه
از آنجا که سرور با آدرس 0.0.0.0 روی رابطهای شبکه در دسترس قرار میگیرد، باید به امنیت آن توجه داشته باشید. این تنظیم بهتنهایی به معنی انتشار سرور در اینترنت نیست، اما دستگاههای قابلدسترسی در شبکه میتوانند به آن درخواست ارسال کنند.
برای استفاده امنتر، این نکات را رعایت کنید:
-
دسترسی پورت سرور را در فایروال به شبکه خصوصی محدود کنید.
-
پورت سرور را مستقیماً روی اینترنت و روتر باز نکنید.
-
اگر نسخه مورد استفاده از قابلیت کلید دسترسی پشتیبانی میکند، از API Key استفاده کنید.
-
برای دستگاههای مهمان از شبکه وایفای جداگانه استفاده کنید.
-
نسخه llama.cpp را بهروز نگه دارید و قابلیتهای اضافی مانند دسترسی به فایلها و اجرای فرمانهای سیستم را بدون نیاز فعال نکنید.
به این ترتیب میتوانید از توان کارت گرافیک برای اجرای هوش مصنوعی محلی استفاده کنید، بدون اینکه دسترسی غیرضروری به کامپیوتر و اطلاعات شخصی خود بدهید.
در مجموع، تبدیل کامپیوتر گیمینگ به سرور هوش مصنوعی میتواند راهکار مناسبی برای استفاده بهتر از سختافزار موجود باشد. با کمک llama.cpp میتوان یک مدل زبانی بزرگ را روی کامپیوتر اجرا کرد و از طریق شبکه خانگی در اختیار سایر دستگاهها قرار داد و حتی برای بهینهسازی خانه هوشمند مفید است. البته میزان حافظه VRAM و توان پردازشی GPU و همچنین امنیت شبکه، نقش مهمی در کیفیت تجربه نهایی دارند.